BAB 2: Bertanya pada Peta: SQL Spasial
#Studi kasus: "Berapa kejadian di tiap petak?"
Kepala Seksi mengirim tiga pertanyaan sekaligus. Berapa kejadian di tiap petak? Berapa tebangan liar yang terjadi dekat jalan? Pos jaga mana yang paling dekat dengan tiap titik panas? Dengan SQL spasial, tiap pertanyaan itu cukup satu kueri, dan jawabannya keluar dalam hitungan milidetik.
#Konsep: SQL spasial dalam tiga kalimat
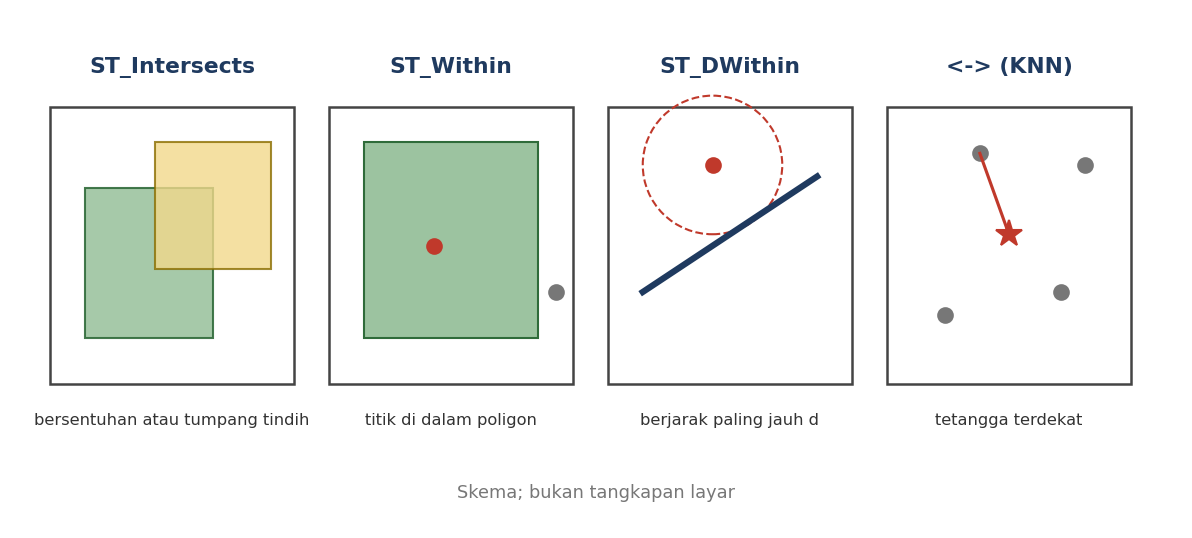
SQL spasial adalah SQL biasa ditambah fungsi yang mengerti letak dan bentuk, dan namanya selalu berawalan ST_. Bayangkan bertanya kepada pustakawan: "Buku mana yang ada di rak ini?" Di sini rak itu adalah poligon petak. Satu kueri bisa menggabungkan tabel berdasarkan letak, bukan hanya berdasarkan nilai kolom.
Istilah baru bab ini:
- Predikat spasial: fungsi yang menjawab ya atau tidak, misalnya
ST_Intersects(bersentuhan) danST_DWithin(berjarak paling jauh sekian). - Pengukur: fungsi yang menjawab angka, misalnya
ST_AreadanST_Distance. - Tetangga terdekat (KNN): mengurutkan hasil menurut kedekatan dengan operator
<->. - View: kueri yang disimpan dan bisa dibuka seperti tabel.
- EXPLAIN: perintah untuk melihat cara server menjalankan kueri.
#Bagian A: QGIS
#Bagian A: SQL spasial di PostGIS, dijalankan lewat QGIS atau psql
Berkas m2_02a_kueri_dasar.sql berisi semua kueri di bawah. Anda bisa menjalankannya dengan psql -f, atau menempelkannya di DB Manager QGIS: Database ► DB Manager, pilih koneksi, lalu buka jendela SQL. Klik Execute. Centang Load as new layer bila hasilnya punya kolom bentuk dan kunci unik. [CEK: letak menu]
#A1. Mengukur: luas tiap petak
SELECT kode, jenis_tegakan, ROUND((ST_Area(geom) / 10000.0)::numeric, 2) AS luas_ha
FROM kph.petak ORDER BY kode;
Hasil uji: 25 baris, mulai P-01 (Sengon, 17,52 ha). Jumlah luas semua petak 400,00 ha, sama dengan luas wilayah 2 km x 2 km. Angka itu bisa dipakai sebagai alat pemeriksa: bila totalnya tidak 400, ada petak tumpang tindih atau berlubang.
#A2. Menggabung berdasarkan letak: kejadian per petak
SELECT p.kode, COUNT(k.gid) AS jumlah
FROM kph.petak AS p
LEFT JOIN kph.kejadian AS k ON ST_Intersects(p.geom, k.geom)
GROUP BY p.kode
ORDER BY jumlah DESC, p.kode
LIMIT 5;
LEFT JOIN menjaga petak yang tidak punya kejadian tetap muncul dengan angka nol. Hasil uji:
| Petak | Kejadian |
|---|---|
| P-04 | 13 |
| P-09 | 12 |
| P-12 | 12 |
| P-08 | 9 |
| P-01 | 7 |
Pemeriksaan: jumlah semua petak = 150 = jumlah baris kph.kejadian. Setiap kejadian jatuh di tepat satu petak.
#A3. Berjarak paling jauh: tebangan liar dekat jalan
SELECT k.jenis,
       COUNT(*) AS total,
       COUNT(*) FILTER (WHERE EXISTS (
           SELECT 1 FROM kph.jalan j WHERE ST_DWithin(k.geom, j.geom, 100))) AS dekat_jalan
FROM kph.kejadian k
GROUP BY k.jenis ORDER BY k.jenis;
ST_DWithin(a, b, 100) berarti "a dan b berjarak paling jauh 100 meter". Hasil uji:
| Jenis | Total | Dalam 100 m dari jalan | Persen |
|---|---|---|---|
| Longsor | 40 | 24 | 60,0 |
| Tebangan liar | 60 | 59 | 98,3 |
| Titik panas | 50 | 36 | 72,0 |
Tebangan liar nyaris selalu dekat jalan (data sintetis sengaja dibuat begitu). Pada data nyata, pola seperti ini menjadi dasar menentukan rute patroli.
#A4. Tetangga terdekat: pos jaga untuk tiap titik panas
SELECT pos.nama AS pos_terdekat, COUNT(*) AS jumlah_titik_panas,
       ROUND(AVG(pos.jarak)::numeric, 1) AS rata_jarak_m
FROM kph.kejadian AS k
CROSS JOIN LATERAL (
    SELECT f.nama, ST_Distance(f.geom, k.geom) AS jarak
    FROM kph.fasilitas AS f
    WHERE f.jenis = 'Pos'
    ORDER BY f.geom <-> k.geom
    LIMIT 1) AS pos
WHERE k.jenis = 'Titik panas'
GROUP BY pos.nama ORDER BY pos.nama;
LATERAL membuat subkueri dijalankan sekali untuk tiap titik panas. Di dalamnya, ORDER BY f.geom <-> k.geom LIMIT 1 mengambil pos terdekat. Hasil uji: Pos Jaga 4 melayani 29 dari 50 titik panas (rata-rata jarak 629,0 m), Pos Jaga 1 hanya 5 titik. Beban pos tidak seimbang.
#A5. Buffer, gabung, dan potong
Berapa luas tiap petak yang berada dalam 50 m dari jalan?
WITH sabuk AS (SELECT ST_Union(ST_Buffer(geom, 50)) AS g FROM kph.jalan)
SELECT p.kode, ROUND((ST_Area(ST_Intersection(p.geom, s.g)) / 10000.0)::numeric, 2) AS ha_dekat_jalan
FROM kph.petak p, sabuk s
ORDER BY ha_dekat_jalan DESC, p.kode LIMIT 5;
Hasil uji: P-03 9,28 ha, P-02 8,73 ha, P-09 8,21 ha, P-08 8,15 ha, P-17 7,67 ha. ST_Union melebur semua buffer jadi satu bidang, jadi bagian yang tumpang tindih tidak dihitung dua kali.
Dua kueri serupa menjawab pertanyaan "dissolve" dan "overlay" dari Seri I1:
-- luas tiap jenis tegakan (dissolve)
SELECT jenis_tegakan, COUNT(*) AS jumlah_petak,
       ROUND((ST_Area(ST_Union(geom)) / 10000.0)::numeric, 2) AS luas_ha
FROM kph.petak GROUP BY jenis_tegakan ORDER BY luas_ha DESC;
Hasil uji: Jati 160,97 ha (10 petak), Mahoni 82,71 ha, Sengon 78,86 ha, Akasia 42,62 ha, Lahan kosong 34,84 ha. Overlay petak dengan tanah memakai ST_Intersection dan hasilnya: Aluvial 46,58 ha, Latosol 146,02 ha, Podsolik 116,70 ha, Regosol 90,70 ha. Totalnya 400,00 ha.
#A6. Mengelompokkan titik
SELECT cid, COUNT(*) FROM (
  SELECT ST_ClusterDBSCAN(geom, eps := 150, minpoints := 3) OVER () AS cid
  FROM kph.kejadian WHERE jenis = 'Titik panas') s
GROUP BY cid ORDER BY cid NULLS LAST;
Hasil uji: satu gerombol berisi 25 titik panas, dan 25 titik lain tersebar (cid kosong). Gerombol itulah yang layak dipantau lebih dulu.
#A7. Indeks spasial dalam angka
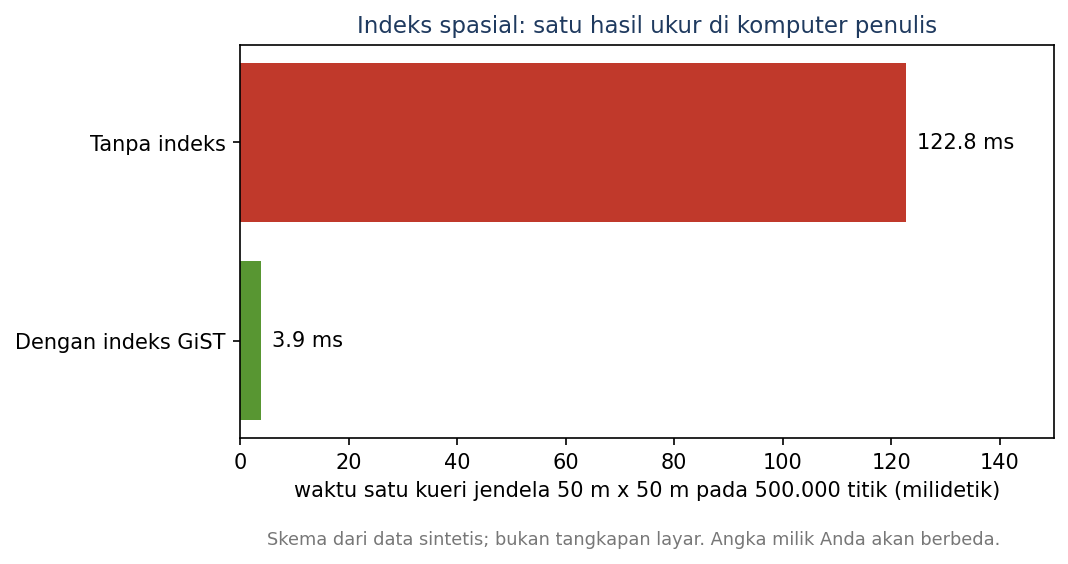
Penulis membuat tabel uji 500.000 titik acak, lalu mencari titik di jendela 50 m x 50 m. Skrip: m2_02b_indeks_dan_view.sql. Ketik EXPLAIN di depan kueri untuk melihat rencananya.
| Keadaan | Rencana server | Waktu (satu kali ukur) |
|---|---|---|
| Tanpa indeks | Parallel Seq Scan (baca semua baris) | 122,8 ms |
Dengan indeks gist | Bitmap Index Scan pada indeks | 3,9 ms |
Keduanya mengembalikan jumlah titik yang sama. Selisihnya sekitar 30 kali pada ukuran ini, dan makin besar pada tabel yang makin besar. Waktu di komputer Anda akan berbeda. Yang penting adalah pola: indeks mengubah "baca semua" menjadi "baca bagian yang perlu".
#A8. View dan view terwujud
View menyimpan kueri. Isinya selalu terbaru karena dihitung ulang tiap dibuka. View terwujud (materialized view) menyimpan hasilnya, cepat tetapi harus disegarkan.
CREATE VIEW kph.v_kejadian_per_petak AS
SELECT p.gid, p.kode, p.geom, COUNT(k.gid) AS jumlah_kejadian
FROM kph.petak p LEFT JOIN kph.kejadian k ON ST_Intersects(p.geom, k.geom)
GROUP BY p.gid, p.kode, p.geom;

CREATE MATERIALIZED VIEW kph.mv_kejadian_per_petak AS SELECT * FROM kph.v_kejadian_per_petak;
REFRESH MATERIALIZED VIEW kph.mv_kejadian_per_petak;
Hasil uji: jumlah awal 150. Setelah satu kejadian ditambahkan, view biasa menunjukkan 151, view terwujud masih 150, dan baru menjadi 151 setelah REFRESH. Kejadian uji itu lalu dihapus.
#A9. SQL yang sama, tanpa server
Bila PostGIS belum tersedia, GeoPackage bisa dikueri dengan SQL bergaya SpatiaLite lewat GDAL. Skrip m2_02c_silang_geopackage.py menjalankan kueri yang sama di sana. Hasil uji: total luas 400,0 ha, tiga petak teratas (P-04 13, P-09 12, P-12 12), dan 59 tebangan liar dekat jalan, semuanya sama persis dengan PostGIS.
Dua perbedaan yang perlu Anda ketahui. Pada uji penulis, jarak ditulis ST_Distance(...) <= 100, karena ST_DWithin dan operator <-> tidak dicoba di dialek itu. Kolom bentuk bernama geom, dan kolom kunci bernama fid.
QGIS punya dua padanan tanpa server (skrip m2_02d_qgis_setara.py):
- Count points in polygon (Processing ► Toolbox): hasil P-04 13, P-09 12, P-12 12.
- Execute SQL (kueri pada layer maya): tabel masukan bernama
input1,input2, dan seterusnya. Hasilnya sama.
#Bagian B: ArcGIS Pro
#Bagian B: ArcGIS Pro
Pro punya dua jalan. Jalan pertama memakai alat bawaan tanpa menulis SQL. Jalan kedua memakai SQL.
- Menggabung berdasarkan letak: alat Spatial Join atau Summarize Within. Pilih petak sebagai sasaran dan kejadian sebagai gabungan. Hasilnya jumlah kejadian per petak. [CEK]
- Berjarak paling jauh: alat Select Layer By Location dengan hubungan Within a distance. [CEK]
- Tetangga terdekat: alat Near atau Generate Near Table. [CEK]
- SQL: untuk tabel di geodatabase perusahaan, Pro memakai fungsi SQL milik Esri (ST_Geometry) bila jenis ruangnya ST_Geometry. Tabel PostGIS dapat dibaca lewat Query Layer (Map ► Add Data ► Query Layer). Fungsi
ST_PostGIS dijalankan oleh PostgreSQL di dalam kueri itu. [CEK]
Pro tidak punya padanan langsung untuk ST_ClusterDBSCAN. Alat Density-based Clustering dalam kotak peralatan Spatial Statistics mengerjakan hal serupa. [CEK]
#Bagian C: ArcMap 10.8
#Bagian C: ArcMap 10.8
- Spatial Join (klik kanan layer ► Joins and Relates ► Join ► Join data from another layer based on spatial location) menghitung kejadian per petak. [CEK]
- Select By Location dengan pilihan are within a distance of the source layer feature. [CEK]
- Near (kotak peralatan Analysis) menghitung jarak ke fasilitas terdekat. [CEK]
- Query Layer: File ► Add Data ► Add Query Layer untuk SQL ke basis data. [CEK]
#Cek paham
- Mengapa kueri A2 memakai
LEFT JOIN, bukanJOINbiasa? - Mana yang lebih baik di klausa
WHERE:ST_Distance(a, b) < 100atauST_DWithin(a, b, 100)? Mengapa? - View terwujud menunjukkan 150 kejadian, padahal sudah ada 151 di tabel. Apa yang harus dilakukan?
Jawaban:
LEFT JOINmempertahankan petak tanpa kejadian dengan hitungan nol.JOINbiasa membuang petak itu dari hasil.ST_DWithin, karena bisa memakai indeks spasial.- Jalankan
REFRESH MATERIALIZED VIEW. View terwujud hanya diperbarui saat disegarkan.
#Kesalahan umum
- Menghitung luas pada data berkoordinat derajat. Hasilnya satuan derajat persegi. Reproyeksi dulu ke UTM, atau pakai tipe
geography. - Lupa indeks spasial pada tabel hasil buatan sendiri. Tabel baru dari
CREATE TABLE AStidak punya indeks. Buat denganCREATE INDEX ... USING gist (geom). - Memakai `JOIN` padahal ingin semua petak muncul. Pakai
LEFT JOIN. - Menggabung dua tabel ber-SRID berbeda. PostGIS akan menolak. Samakan dengan
ST_Transform.
#Ringkasan dan latihan
Ringkasan: SQL spasial menggabung tabel berdasarkan letak. Predikat menjawab ya atau tidak, pengukur menjawab angka, <-> mengurutkan menurut kedekatan. Indeks spasial dan ST_DWithin membuatnya cepat.
Latihan: tulis kueri yang menghitung, untuk tiap petak, jumlah longsor dalam jarak 200 m dari sungai. (Tabel sungai dibuat di Bab 4; sementara itu pakai jalan.) Periksa bahwa jumlah semua petak tidak melebihi 40.
#Tabel perbandingan: pekerjaan yang sama di tiga perangkat
| Pekerjaan | QGIS dan PostGIS | ArcGIS Pro | ArcMap 10.8 |
|---|---|---|---|
| Hitung kejadian per petak | ST_Intersects + GROUP BY, atau Count points in polygon | Summarize Within [CEK] | Spatial Join [CEK] |
| Dalam jarak tertentu | ST_DWithin | Select Layer By Location [CEK] | Select By Location [CEK] |
| Terdekat | ORDER BY <-> LIMIT 1 | Generate Near Table [CEK] | Near [CEK] |
| SQL pada basis data | DB Manager, Execute SQL | Query Layer [CEK] | Add Query Layer [CEK] |