BAB 6: Mesin yang Belajar: Hutan Acak pada Deret Waktu
#Studi kasus: "Satu peta untuk semua kejadian"
Bab 4 dan 5 menghasilkan peta deforestasi dan peta bekas bakar dengan aturan dan ambang buatan Anda. Kepala Seksi senang, lalu bertanya, "Bisakah satu peta langsung menyebut mana hutan stabil, hutan tanaman, sawah, bukaan, bekas bakar, dan panen? Tanpa aturan yang berbeda-beda tiap kasus." Inilah pekerjaan yang cocok untuk machine learning: Anda memberi contoh, mesin mencari aturannya.
#Konsep: hutan acak dalam tiga kalimat
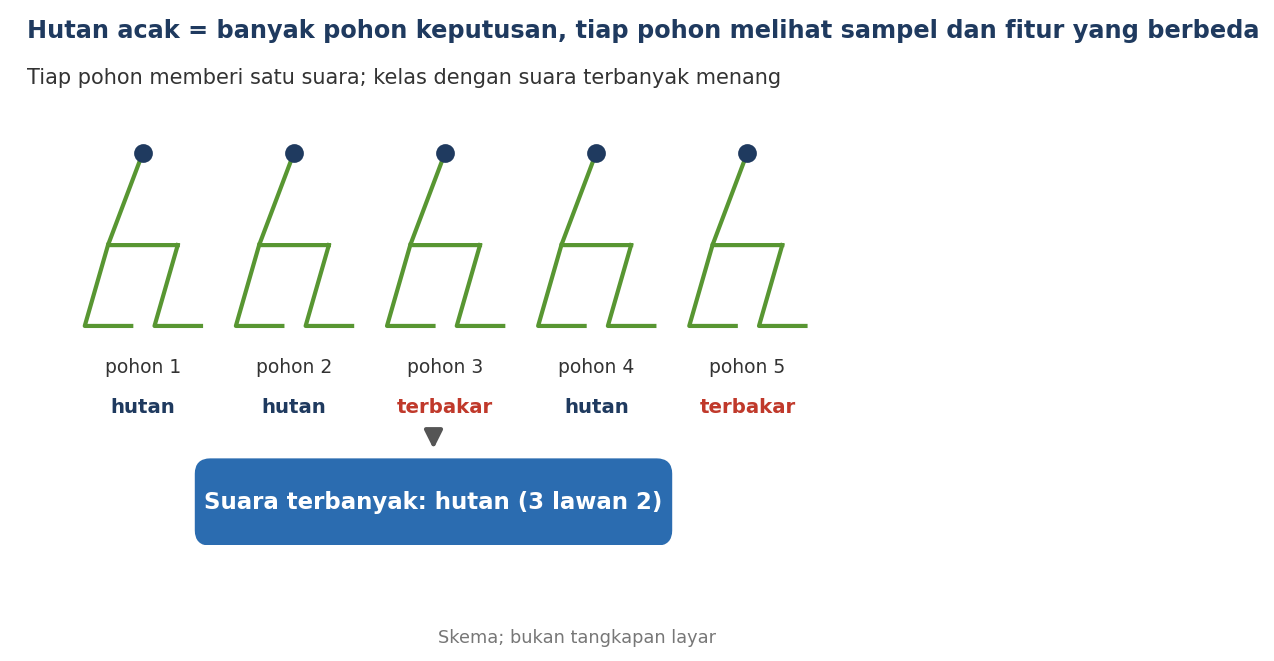
Pohon keputusan itu seperti permainan tebak-tebakan yang berisi pertanyaan bercabang ("NBR minimumnya di bawah 0,2? Ya, maka terbakar"). Hutan acak adalah ratusan pohon yang masing-masing belajar dari contoh dan fitur berbeda, lalu memberi suara, dan suara terbanyak menang. Hasilnya lebih stabil daripada satu pohon, seperti keputusan panitia yang lebih tepercaya daripada satu juri.
Istilah baru bab ini:
- Fitur: angka yang menjelaskan sebuah piksel (misalnya NDVI rata-rata, NBR minimum).
- Sampel latih: titik yang kelasnya sudah diketahui, dipakai untuk belajar.
- Pohon keputusan: aturan bercabang "jika... maka...".
- Hutan acak (random forest): banyak pohon yang memberi suara.
- Kepentingan fitur: seberapa sering sebuah fitur dipakai untuk memisahkan kelas.
#Di mana bedanya dengan M1 Bab 5?
M1 Bab 5 membahas klasifikasi berbasis objek pada satu citra komposit: citra dipotong menjadi segmen, lalu segmen diklasifikasi dengan Random Forest lewat OTB. Di sini, Anda bekerja per piksel, dan fiturnya berasal dari riwayat waktu, bukan dari warna satu hari. Algoritmanya sama, bahannya berbeda. Kekuatan deret waktu: kelas yang mirip pada satu hari sering berbeda dalam perilaku, misalnya hutan stabil dan sawah yang sedang hijau.
#Menyusun fitur dari deret waktu
Skrip 6.1 membuat 12 fitur per piksel dari NDVI, NBR, dan SWIR1 yang sudah ditambal (Bab 2):
| Kelompok | Fitur |
|---|---|
| Kehijauan | rata-rata, minimum, maksimum, simpangan baku, tren per tahun |
| Perubahan | penurunan terbesar antar-tanggal, selisih 4 tanggal akhir dikurangi 4 tanggal awal |
| Kebakaran | NBR rata-rata, NBR minimum, penurunan NBR terbesar, selisih akhir dikurangi awal |
| Mineral dan kelembapan | SWIR1 rata-rata |
#Bagian A: QGIS
#Bagian A: Hutan acak di QGIS
QGIS tidak memiliki alat Random Forest bawaan di Processing Toolbox. Ada tiga jalan.
- OTB (Orfeo Toolbox): seperti di M1 Bab 5. Dipasang terpisah.
- scikit-learn di Python QGIS: perlu dipasang ke Python QGIS. Di data latihan, skrip memakainya bila ada. [CEK: tidak terpasang di lingkungan uji]
- hutan_mini.py: hutan acak ringkas buatan penulis dengan NumPy saja. Tujuannya belajar dan menjalankan buku ini tanpa pemasangan tambahan. Ia meniru antarmuka scikit-learn:
fit,predict, danfeature_importances_.
A.1 Membangun tumpukan fitur (Skrip 6.1)
# SKRIP 6.1 (cuplikan; berkas lengkap: skrip/6_1_fitur_deret.py)
ndvi = U.isi_waktu(U.nilai_ndvi(refl), baik, hari)      # NDVI tanpa lubang
fitur = {"ndvi_rata": ndvi.mean(0), "ndvi_min": ndvi.min(0), "ndvi_maks": ndvi.max(0),
         "ndvi_tren": tren_tahun(ndvi), "ndvi_turun_maks": np.diff(ndvi, axis=0).min(0),
         "nbr_rata": nbr.mean(0), "nbr_min": nbr.min(0), "swir1_rata": b11.mean(0)}   # dan seterusnya
Hasil: fitur_deret.tif dengan 12 band. Nama fitur disimpan sebagai nama band.
A.2 Mengambil nilai fitur pada titik latih
Buka Titik_Latih.gpkg: 200 titik, 25 per kelas, dengan field KELAS (1 sampai 8). Jalankan Sample raster values (Processing Toolbox ► Raster analysis) dengan fitur_deret.tif. Hasilnya field baru berisi nilai tiap fitur pada tiap titik.
A.3 Melatih dan menguji dulu (Skrip 6.2)
# SKRIP 6.2 (cuplikan; berkas lengkap: skrip/6_2_latih_klasifikasi.py)
try:
    from sklearn.ensemble import RandomForestClassifier
except ImportError:
    from hutan_mini import RandomForestClassifier
s = processing.run("native:rastersampling", {"INPUT": titik, "RASTERCOPY": fitur_tif, "COLUMN_PREFIX": "f",
                                             "OUTPUT": "TEMPORARY_OUTPUT"})["OUTPUT"]
model = RandomForestClassifier(n_estimators=200, random_state=1).fit(X, y)
peta = model.predict(st.reshape(nb, -1).T).reshape(H, W)
Antarmuka sama persis, sehingga baris import memilih alat yang tersedia.
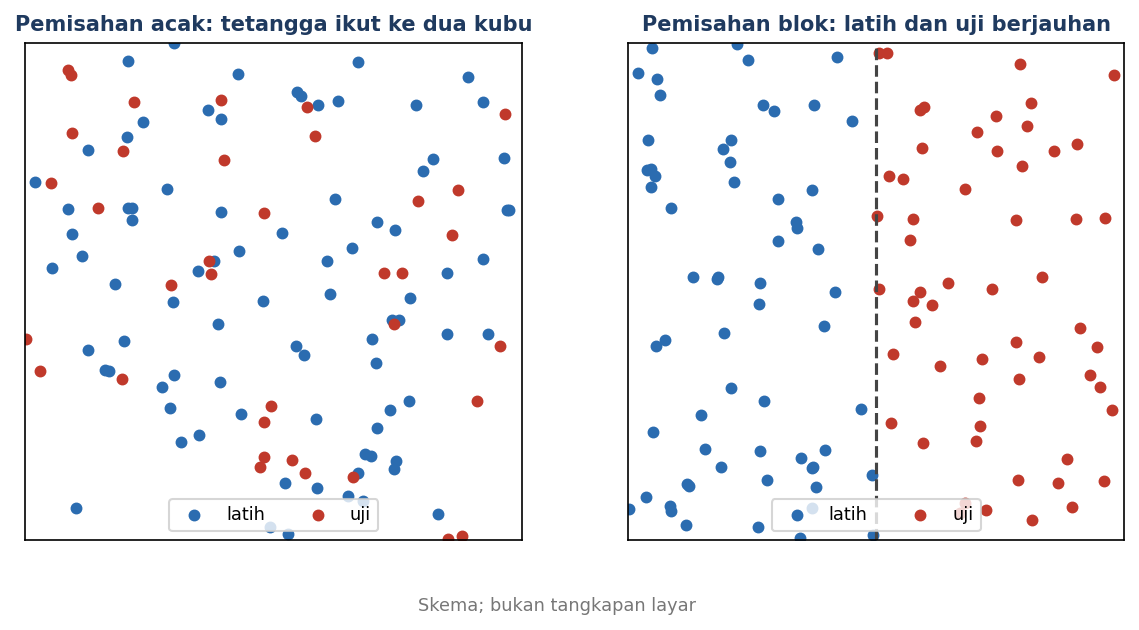
Dua cara menguji, dua hasil sangat berbeda. Skrip 6.2 membagi titik latih menjadi empat lipatan, lalu melatih pada tiga lipatan dan menguji pada satu (uji silang). Ada dua cara membagi:
| Cara membagi | Akurasi tiap lipatan | Rata-rata |
|---|---|---|
| Acak | 0,98; 1,00; 1,00; 1,00 | 0,995 |
| Blok ruang (empat kuadran area) | 0,50; 0,89; 0,63; 0,44 | 0,617 |
[terbukti: dihitung dari data sintetis; hutan_mini.py]
Mengapa bedanya begitu besar? Pada pembagian acak, tetangga yang mirip ikut ke kubu latih dan kubu uji, sehingga mesin tinggal "menyontek" tetangganya. Pada pembagian blok, uji dilakukan di tempat yang tidak pernah dilihat. Di area kecil ini, beberapa kelas hanya ada di satu kuadran, misalnya bekas bakar utama di Beta dan panen di Alpha, jadi saat satu kuadran disisihkan, mesin tidak pernah melihat kelas itu. Nilai 0,617 ini keras dan sebagian karena ukuran area. Intinya: uji acak cenderung terlalu optimis. Di pekerjaan nyata, wilayahnya luas dan tiap kelas tersebar di banyak tempat, sehingga uji blok memberi gambaran lebih jujur. Bab 7 memperdalam ini.
A.4 Peta hasil dan fitur terpenting
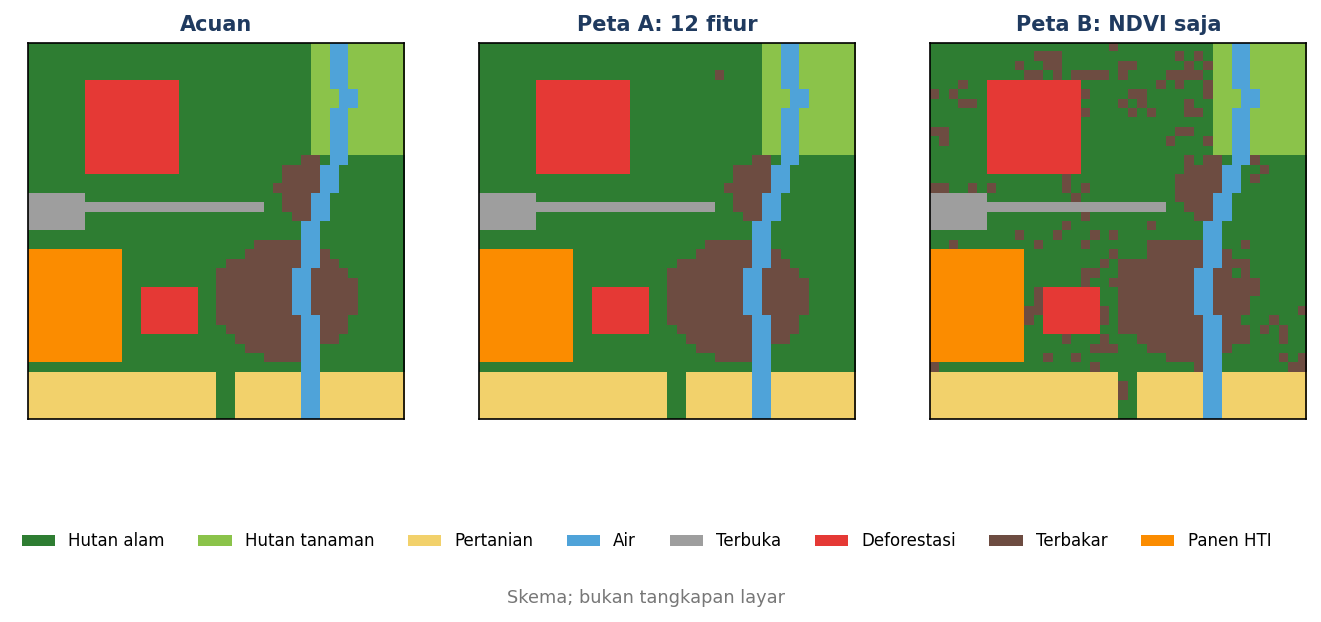
Model akhir dilatih pada seluruh 200 titik dan dipakai pada seluruh 1.600 piksel. Lima fitur terpenting: nbr_rata (0,13), ndvi_rata (0,12), ndvi_maks (0,12), swir1_rata (0,12), dan nbr_min (0,11). Nilainya hampir sama karena banyak fitur saling menggantikan.
Luas hasil peta lawan luas acuan:
| Kelas | Peta (ha) | Acuan (ha) |
|---|---|---|
| Hutan alam | 7,99 | 8,00 |
| Hutan tanaman | 0,96 | 0,96 |
| Pertanian | 1,80 | 1,80 |
| Air | 0,80 | 0,80 |
| Terbuka | 0,43 | 0,43 |
| Deforestasi | 1,30 | 1,30 |
| Terbakar | 1,52 | 1,51 |
| Panen hutan tanaman | 1,20 | 1,20 |
A.5 Fitur apa yang diperlukan? Percobaan sederhana
Fitur menentukan hasil lebih daripada algoritmanya. Skrip 7.1 (Bab 7) melatih ulang hutan acak hanya dengan tujuh fitur NDVI, tanpa SWIR. Hasilnya: bekas bakar tercampur dengan hutan. Pelajaran: berikan mesin informasi yang memang membedakan kelas.
#Bagian B: ArcGIS Pro
#Bagian B: ArcGIS Pro
- Fitur: bangun raster multiband dari fitur (seperti 6.1) atau pakai raster multidimensi.
- Latih: Train Random Trees Classifier (Image Analyst Tools, perlu ekstensi Image Analyst atau Spatial Analyst). Masukan: raster dan training feature class dengan field
classnamedanclassvalue. Parameter penting: Max Number of Trees, Max Tree Depth, dan Max Number of Samples Per Class (bawaan 1000). Hasilnya berkas.ecd, definisi classifier berformat JSON. - Terapkan: Classify Raster dengan berkas
.ecd. - Dokumentasi Esri menyatakan semua yang di atas. Cocokkan dengan versi Anda. [CEK]
#Bagian C: ArcMap 10.8
#Bagian C: ArcMap 10.8
ArcMap tidak punya padanan untuk Random Trees yang saya temukan di dokumentasi. [CEK: periksa instalasi Anda]
- Alternatif klasik: Create Signatures dari sampel latih, lalu Maximum Likelihood Classification. Dokumentasi ArcMap menyebut berkas signature berekstensi
.gsg, dibuat dari Create Signature, Edit Signature, atau Iso Cluster, dan alat ini memerlukan lisensi Spatial Analyst. - Hutan acak dalam Python: lewat skrip di luar ArcMap, memakai Python 3 dan scikit-learn. [CEK]
#Cek paham
- Mengapa beda akurasi uji acak (0,995) dan uji blok (0,617) begitu besar?
- Apa yang dimaksud fitur dalam klasifikasi deret waktu?
- Mengapa menambah fitur SWIR memperbaiki pemisahan bekas bakar?
Jawaban:
- Pada uji acak, tetangga yang mirip ikut ke dua kubu, sehingga mesin menyontek. Uji blok menguji di tempat yang belum pernah dilihat. Di area kecil ini, sebagian kelas juga hanya ada di satu blok.
- Angka ringkas dari riwayat waktu sebuah piksel, misalnya NDVI rata-rata, NDVI minimum, atau tren.
- Bekas bakar ditandai oleh turunnya NIR dan naiknya SWIR. NDVI saja tidak menangkap pembalikan itu sekuat NBR.
#Kesalahan umum
- Menguji pada data yang sama dengan latihan. Akurasi nyaris sempurna, tetapi menyesatkan.
- Memakai pembagian acak untuk data bertetangga. Hasilnya terlalu optimis. Pakai blok ruang.
- Memberi fitur yang bocor dari jawaban. Fitur tidak boleh dihitung dari peta acuan.
- Sampel latih tidak seimbang atau tidak mewakili. Kelas langka perlu cukup contoh.
#Ringkasan dan latihan
Ringkasan: hutan acak adalah banyak pohon yang memberi suara. Fitur dari deret waktu membuat satu model bisa membedakan kelas yang tampak mirip pada satu hari. Cara menguji menentukan seberapa jujur akurasinya.
Latihan:
- Jalankan Skrip 6.1 dan 6.2. Catat dua angka uji silang.
- Ubah
n_estimatorsdi Skrip 6.2 menjadi 20, lalu 400. Apa perubahannya pada akurasi uji silang blok? - Hapus tiga fitur NBR dari
Xdan latih ulang. Kelas mana yang menurun?
#Tabel perbandingan: machine learning pada deret waktu
| Langkah | QGIS | ArcGIS Pro | ArcMap 10.8 | Status |
|---|---|---|---|---|
| Ambil nilai fitur pada titik | Sample raster values | Extract Multi Values to Points [CEK] | Extract Multi Values to Points [CEK] | QGIS terbukti |
| Latih Random Forest | OTB, scikit-learn, atau hutan_mini.py | Train Random Trees Classifier | Tidak ada padanan | QGIS: hutan_mini terbukti; Pro: dokumentasi |
| Terapkan model | predict lewat skrip | Classify Raster | Maximum Likelihood Classification | Pro: dokumentasi; ArcMap: dokumentasi |
| Uji silang blok | Skrip | Skrip [CEK] | Skrip [CEK] | QGIS terbukti |